
پردازش زبان طبیعی (NLP) قلب تپنده بسیاری از سیستمهای هوش مصنوعی امروزی است که به رایانهها امکان میدهد زبان انسان را درک کرده و با آن تعامل داشته باشند. این مقاله به بررسی عمیق NLP، از تعاریف پایه و تاریخچه آن گرفته تا مراحل کلیدی، ابزارها، کاربردها و چالشهای پیش رو میپردازد. اگر به دنبال درک چگونگی عملکرد چتباتها، دستیارهای صوتی یا سیستمهای ترجمه ماشینی هستید، یا میخواهید ایجنتهای کدنویسی خود را با قابلیتهای زبانی هوشمندتر کنید، این راهنما برای شماست.
با پیشپردازش دادهها، بردارسازی متن و استفاده از مدلهای پیشرفته، میتوانید به رایانههای خود بیاموزید که چگونه زبان را بفهمند و پاسخهای هوشمندانه تولید کنند. در بلاگ هوشی، گامهای بعدی را برای شروع کار با NLP و ساخت توکن API برای پروژههای خود پیدا خواهید کرد.
پردازش زبان طبیعی (NLP) چیست و چرا به آن نیاز داریم؟
پردازش زبان طبیعی (Natural Language Processing) به رایانهها کمک میکند تا زبان انسان را – چه به صورت متن و چه گفتار – درک کرده، تفسیر کنند و حتی تولید کنند. این شاخه از هوش مصنوعی، پلی میان دنیای پیچیده زبان انسانی و منطق ساختاریافته کامپیوترها ایجاد میکند.
هنگامی که شما با یک دستیار صوتی صحبت میکنید، سوالی را در موتور جستجو تایپ میکنید، یا پیامی را به یک چتبات ارسال میکنید، در واقع در حال تعامل با یک سیستم NLP هستید. این سیستمها باید بتوانند معنای کلمات و جملات شما را تشخیص دهند، هدف شما را درک کنند و پاسخی مناسب و مرتبط ارائه دهند. برای مثال، در پلتفرم هوشی، ایجنتهای کدنویسی میتوانند با استفاده از NLP، دستورات شما را به کدهای قابل اجرا تبدیل کنند.
کاربردهای NLP فراتر از تعاملات مستقیم است. این فناوری در خودکارسازی کارهای تکراری نقش حیاتی دارد؛ مثلاً چتباتها میتوانند به سوالات متداول پاسخ دهند و به تیمهای پشتیبانی اجازه دهند روی مسائل پیچیدهتر تمرکز کنند. تحلیل احساسات مشتریان، خلاصهسازی اسناد، و تشخیص اسپم نیز از دیگر کاربردهای مهم NLP هستند که به شرکتها کمک میکنند تا تصمیمات آگاهانهتری بگیرند و تجربه مشتری را بهبود بخشند. این فناوری با کاهش زمان پاسخگویی و افزایش دقت خدمات، بهرهوری را به طور چشمگیری افزایش میدهد.
تاریخچه NLP: از ترجمه ماشینی تا مدلهای امروزی
سفر پردازش زبان طبیعی از دهه ۱۹۵۰ آغاز شد. در سال ۱۹۵۴، آزمایش تاریخی Georgetown-IBM نشان داد که ترجمه ماشینی حتی در مراحل اولیه خود نیز امکانپذیر است. در دهههای ۱۹۹۰ و ۲۰۰۰، ابزارهایی مانند فیلترهای اسپم و سیستمهای دستهبندی متن با تکیه بر روشهای آماری و ویژگیهای ساده، رایج شدند.
با پیشرفت فناوری و افزایش توان پردازشی، یادگیری عمیق وارد صحنه شد. دهه ۲۰۱۰ شاهد ظهور شبکههای عصبی دنبالهای (RNNs) و مدلهای Seq2Seq بود که کیفیت ترجمه ماشینی را به طرز چشمگیری بهبود بخشیدند. نقطه عطف بزرگ در سال ۲۰۱۷ با معرفی معماری Transformer در مقاله «Attention Is All You Need» رقم خورد. این معماری با مکانیزم توجه و قابلیت آموزش موازی، انقلابی در یادگیری زبان ایجاد کرد.
پس از آن، مدلهای بزرگ زبان (LLMs) مانند GPT-3 با صدها میلیارد پارامتر، توانایی تولید متن روان و طبیعی را به سطحی بیسابقه رساندند. این مدلها امروزه در طیف وسیعی از کاربردها، از تولید محتوا گرفته تا پاسخگویی به سوالات پیچیده، مورد استفاده قرار میگیرند. در هوشی، شما میتوانید از قدرت این مدلها برای ساخت ایجنتهای هوشمند خود بهرهبرداری کنید.
NLP چگونه کار میکند؟ از پیشپردازش تا یادگیری عمیق
پردازش زبان طبیعی شامل چندین مرحله کلیدی است که متن خام را به دادههای قابل فهم برای ماشین تبدیل میکند:
- تمیز کردن متن: در این گام، خطاهای املایی، نشانههای نگارشی اضافی، و فاصلههای بیمورد حذف میشوند تا دادهها برای مراحل بعدی آماده شوند.
- آمادهسازی و یکنواختسازی:
- توکنسازی (Tokenization): متن به واحدهای کوچکتر مانند کلمات یا جملات تقسیم میشود.
- کوچکسازی حروف (Lowercasing): تمامی حروف به حالت کوچک تبدیل میشوند تا تفاوتهای غیرضروری از بین برود.
- حذف توقفواژهها (Stop Word Removal): کلمات رایج و کممعنا مانند «از»، «به»، «یک» حذف میشوند.
- ریشهیابی (Lemmatization/Stemming): کلمات به ریشه اصلی خود بازگردانده میشوند (مثلاً «میروم»، «رفتم» به «رفتن»).
- تبدیل متن به داده عددی (Feature Extraction): متن به بردارهای عددی تبدیل میشود. روشهایی مانند Bag of Words و TF-IDF فراوانی کلمات را ثبت میکنند، در حالی که روشهای پیشرفتهتر مانند Word2Vec و GloVe روابط معنایی را نیز در خود جای میدهند. مدلهای Transformer از روشهای پیچیدهتری برای ایجاد بردارهای متنی استفاده میکنند.
- آموزش مدل: مدلهای یادگیری ماشین و یادگیری عمیق روی دادههای عددی آموزش میبینند تا الگوهای زبانی را یاد بگیرند و وظایف خاصی مانند دستهبندی، ترجمه یا تولید متن را انجام دهند.
- استفاده از مدلهای پیشرفته: مدلهای Transformer مانند BERT و GPT پایه اصلی بسیاری از سیستمهای NLP امروزی هستند که کیفیت تحلیل و درک زبان را به طور چشمگیری بهبود بخشیدهاند.
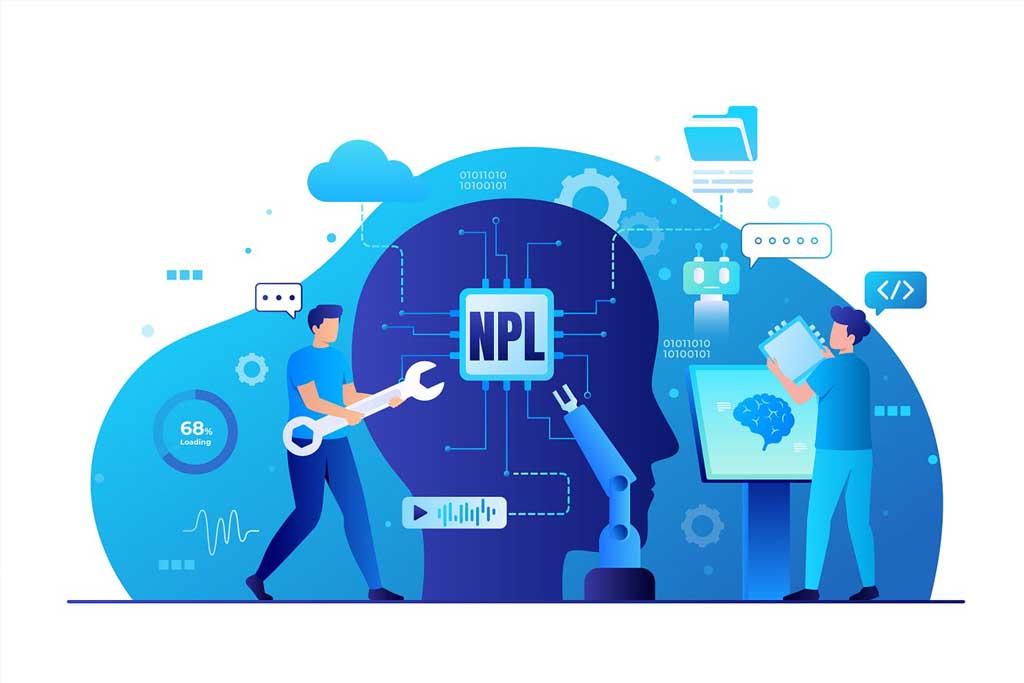
مراحل پیشپردازش متن در پردازش زبان طبیعی
هدف اصلی پیشپردازش، سادهسازی و استانداردسازی متن برای مدلهای هوش مصنوعی است. توکنسازی، متن را به واحدهای معنایی کوچکتر تقسیم میکند. کوچکسازی حروف، تفاوتهای غیرضروری را از بین میبرد. حذف توقفواژهها، تمرکز مدل را روی کلمات مهمتر معطوف میکند. ریشهیابی، اشکال مختلف یک کلمه را یکسانسازی میکند. در نهایت، پاکسازی از نشانهها، فاصلههای اضافه و خطاهای تایپی، دادهای تمیز و با کیفیت برای آموزش مدل فراهم میآورد. دادههای تمیز، منجر به آموزش بهتر و نتایج دقیقتر میشوند.
تبدیل متن به دادههای عددی (ویژگیسازی)
پس از پیشپردازش، متن باید به فرمت عددی تبدیل شود تا ماشینها بتوانند آن را پردازش کنند. روش Bag of Words تعداد تکرار کلمات را میشمارد اما ترتیب آنها را نادیده میگیرد. TF-IDF اهمیت هر کلمه را در یک سند نسبت به کل مجموعه اسناد مشخص میکند و برای دستهبندی متنها مفید است. روشهای Word2Vec و GloVe، معنای کلمات را در قالب بردارهای متراکم (Embeddings) نشان میدهند. در Word2Vec، مدل Skip-Gram از یک کلمه مرکزی برای پیشبینی کلمات همسایه استفاده میکند، در حالی که CBOW برعکس عمل میکند. در مدلهای پیشرفتهتر، بردارهای کلمات بر اساس زمینه جمله تغییر میکنند که این نمایشها، پایه اصلی یادگیری در NLP هستند.
نقش یادگیری ماشین و یادگیری عمیق در NLP
یادگیری ماشین برای شناسایی الگوها در متن به کار میرود. الگوریتمهایی مانند رگرسیون لجستیک و Naive Bayes برای دستهبندی متن و تشخیص اسپم استفاده میشوند. روشهای مارکوف پنهان (HMM) برای دادههای توالی مانند تشخیص بخش گفتار (Part-of-Speech Tagging) کاربرد دارند.
یادگیری عمیق با شبکههای عصبی پیچیدهتر، تواناییهای بیشتری را به NLP آورده است. شبکههای LSTM و GRU میتوانند وابستگیهای طولانیمدت را در متن حفظ کنند. مدلهای Seq2Seq در ترجمه ماشینی و خلاصهسازی متن کاربرد دارند و مکانیزم توجه (Attention Mechanism) دقت آنها را به شدت افزایش داده است. امروزه، معماری Transformer با قابلیت پردازش موازی و درک عمیقتر از زمینه، نقش اصلی را در مدلهای پیشرفته مانند BERT و GPT ایفا میکند. این مدلها در تولید متن، پاسخ به پرسش و خلاصهسازی بسیار مؤثر هستند.
تکنیکها و روشهای کلیدی در پردازش زبان طبیعی
برای پیادهسازی موفقیتآمیز پروژههای NLP، انتخاب و استفاده از تکنیکهای مناسب ضروری است. این تکنیکها از روشهای آماری ساده تا مدلهای پیچیده یادگیری عمیق را شامل میشوند:
- استفاده از روشهای آماری ساده برای شروع و مقایسه عملکرد.
- بهرهگیری از بردارهای فشرده (Embeddings) برای نمایش معنایی بهتر کلمات.
- استفاده از مکانیزم توجه برای تمرکز مدل بر بخشهای مهم جمله.
- تنظیم دقیق مدلهای از پیش آموزشدیده (Pre-trained Models) برای کارهای خاص با دادههای هدف.
- ارزیابی مداوم مدل با استفاده از مجموعه دادههای مجزا و معیارهای دقیق.
تکنیکهای سنتی مانند Bag of Words و TF-IDF
روشهای سنتی، هرچند ساده، اما در بسیاری از موارد کارآمد هستند. Bag of Words (کیسه کلمات) تعداد تکرار کلمات را میشمارد و سریع اجرا میشود، اما ترتیب کلمات را در نظر نمیگیرد. با این حال، برای کارهای پایهای مانند دستهبندی اسناد مفید است. TF-IDF (Term Frequency-Inverse Document Frequency) اهمیت هر کلمه را در یک سند نسبت به کل مجموعه اسناد مشخص میکند. این روش برای جستجو و دستهبندی متن مناسب است، هزینه محاسباتی کمی دارد و در پروژههای کوچک بسیار کاربردی است.
روشهای مدرن مثل Word2Vec، GloVe و BERT
روشهای مدرن، نمایش معنایی کلمات را با دقت بسیار بالاتری ایجاد میکنند. Word2Vec با مدلهای Skip-Gram و CBOW، روابط معنایی کلمات را در بردارهای فشرده نشان میدهد. GloVe نیز با استفاده از ماتریس هموقوعی کلمات، بردارهای معنایی را تولید میکند. در مدلهای زمینهمحور (Contextualized Embeddings)، معنی یک کلمه با توجه به جملهای که در آن قرار گرفته، تغییر میکند. BERT (Bidirectional Encoder Representations from Transformers) یکی از شناختهشدهترین نمونههاست که با آموزش گسترده و تنظیم دقیق (Fine-tuning) روی کارهای خاص، کیفیت بینظیری را ارائه میدهد. این روشها دقت مدلهای NLP را به شدت افزایش دادهاند، اما هزینه محاسباتی بیشتری نیز دارند.
مدلهای مهم و تاثیرگذار در پردازش زبان طبیعی
شناخت مدلهای مختلف، درک مسیر پیشرفت NLP را آسانتر میکند. هر نسل از مدلها، قابلیتهای جدیدی را به ارمغان آورده است:
- الیزا (دهه ۱۹۶۰): نشان داد که قواعد ساده میتوانند گفتوگوهای اولیه را شبیهسازی کنند.
- مدلهای آماری (دهه ۱۹۹۰): فیلتر اسپم و دستهبندی متن را ممکن ساختند.
- مدلهای Seq2Seq (دهه ۲۰۱۰): ترجمه ماشینی را به طور چشمگیری بهبود بخشیدند.
- معماری Transformer (۲۰۱۷): آموزش سریعتر و دقیقتر مدلهای زبان را فراهم کرد.
- مدلهای بزرگ زبان (LLMs) (از ۲۰۱۹): توانایی تولید متن روان و طبیعی را به سطحی بیسابقه رساندند.
کاربردهای پردازش زبان طبیعی در زندگی روزمره و صنایع
پردازش زبان طبیعی به طور فزایندهای در زندگی روزمره ما نفوذ کرده و کارهای ما را سادهتر میکند. این فناوری به ما کمک میکند تا با دستگاهها راحتتر تعامل کنیم و پاسخهای دقیقتری دریافت کنیم. بسیاری از سرویسهایی که روزانه از آنها استفاده میکنیم، بر پایه NLP کار میکنند و تجربه کاربری ما را بهبود میبخشند.
کاربردهای NLP در زندگی روزمره
- دستیارهای صوتی: دستیارهایی مانند Siri و Google Assistant از NLP برای درک دستورات صوتی و ارائه پاسخهای مرتبط استفاده میکنند.
- چتباتهای پشتیبانی: رباتهای گفتگو در وبسایتها و اپلیکیشنها، با NLP به سوالات کاربران پاسخ میدهند و پشتیبانی اولیه را فراهم میکنند.
- ترجمه ماشینی: ابزارهایی مانند Google Translate و DeepL از NLP برای ترجمه متون بین زبانهای مختلف استفاده میکنند.
- سیستمهای پیشنهادی: پلتفرمهایی مانند آمازون و نتفلیکس از NLP برای تحلیل علایق شما و پیشنهاد محصولات یا محتوای مرتبط استفاده میکنند.
- تحلیل بازخورد مشتری: شرکتها با استفاده از NLP، نظرات و بازخوردهای مشتریان را تحلیل کرده و احساسات آنها را نسبت به محصولات یا خدمات خود درک میکنند.
نقش پردازش زبان طبیعی در صنایع مختلف
کاربرد NLP فراتر از زندگی روزمره است و در صنایع گوناگون نیز تأثیرات عمیقی دارد:
- پزشکی و تحلیل دادههای سلامت: یادداشتهای پزشکان و پروندههای پزشکی حاوی اطلاعات فراوانی هستند که تحلیل دستی آنها زمانبر است. NLP میتواند نکات مهم را از این متون استخراج کرده، الگوها را شناسایی کند و به تشخیص بهتر و پیشنهاد درمانهای مؤثرتر کمک کند. این کار خطای انسانی را کاهش داده و مراقبت دقیقتری را برای بیماران فراهم میآورد.
- مالی و کشف تقلب: در صنعت مالی، حجم عظیمی از پیامها، گزارشها و تراکنشها وجود دارد. مدلهای NLP میتوانند متنها و الگوهای تراکنش را کنار هم بررسی کنند. اگر نشانهای از رفتار غیرعادی یا مشکوک باشد، سیستم هشدار میدهد. این روند از ضررهای بزرگ جلوگیری کرده و اعتماد را در سیستم مالی افزایش میدهد.
- حقوقی و مدیریت اسناد: پروندههای حقوقی شامل هزاران سند و بندهای پیچیده هستند. NLP میتواند بندهای مهم را برجسته کند، دستهبندی اسناد را آسان کند و به وکلا کمک کند تا با چند جستجو به متن هدف خود برسند. این روش دقت بررسی را افزایش داده و زمان و هزینه مدیریت اسناد را به شدت کاهش میدهد.
چالشها و محدودیتهای پردازش زبان طبیعی
با وجود پیشرفتهای چشمگیر، زبان انسان پر از ظرافت و چندلایگی است و فهم کامل آن برای ماشینها همچنان چالشبرانگیز است. مدلها گاهی معنی را اشتباه برداشت میکنند یا زمینه (Context) را از دست میدهند. دادههای آموزشی نیز همیشه کامل و بدون سوگیری نیستند و میتوانند مشکلاتی ایجاد کنند. از سوی دیگر، مدلهای بزرگ زبان (LLMs) انرژی و هزینه زیادی میخواهند که توسعه و استقرار آنها را با چالش مواجه میکند.
ابهامهای زبانی و چندمعنایی
بسیاری از کلمات در زبان انسان بیش از یک معنی دارند و درک صحیح آنها به زمینه جمله بستگی دارد. برای مثال، کلمه «شیر» میتواند به حیوان، مایع نوشیدنی یا ابزار آب اشاره داشته باشد. مدل NLP باید جملات اطراف را بررسی کند تا برداشت درستی داشته باشد. پردازش زبان با استفاده از نشانههای زمینهای تلاش میکند این ابهام را کاهش دهد. هرچه دادههای زمینهای بهتر باشند، خطای مدل کمتر میشود.
سوگیری دادهها و پیامدهای آن
اگر دادههای آموزشی مدل دارای سوگیری (Bias) باشند، خروجی مدل نیز همان سوگیری را نشان خواهد داد. این مسئله میتواند در کاربردهایی مانند استخدام، ارزیابی اعتبار یا تشخیص بیماری، منجر به نتایج ناعادلانه شود. برای مقابله با این چالش، باید دادهها به دقت بازبینی و متوازن شوند تا مدل بیطرفتر عمل کند. همچنین، ارزیابی مداوم مدلها میتواند خطاهای پنهان را آشکار کند و به افزایش اعتمادپذیری سیستمهای NLP کمک کند.
هزینه و مصرف انرژی مدلهای بزرگ
مدلهای بزرگ زبان مانند GPT-3 و سایر LLMs، منابع محاسباتی عظیمی را طلب میکنند. آموزش و اجرای آنها انرژی بسیار بالایی مصرف میکند و پرهزینه است. برای کاهش این هزینهها، محققان به دنبال توسعه نسخههای کوچکتر و کارآمدتر (مانند مدلهای فشردهسازی شده یا تقطیر دانش) هستند. این نسخهها سرعت بهتری دارند و نیاز کمتری به سختافزار گرانقیمت دارند. مدیریت صحیح منابع، NLP را در دسترستر و پایدارتر میکند. در داشبورد هوشی، شما میتوانید مصرف منابع خود را به صورت شفاف مشاهده و مدیریت کنید.
ابزارها و زبانهای برنامهنویسی برای پردازش زبان طبیعی
برای ساخت سامانههای NLP، ابزارها و زبانهای برنامهنویسی متنوعی وجود دارد. پایتون به دلیل داشتن کتابخانههای غنی و جامعه کاربری بزرگ، محبوبترین زبان در این حوزه است. چارچوبهای یادگیری عمیق نیز امکان ساخت مدلهای پیچیده را فراهم میکنند. انتخاب ابزار مناسب به هدف پروژه و تواناییهای تیم بستگی دارد.
کتابخانههای پایتون مانند NLTK، spaCy و Hugging Face
- NLTK (Natural Language Toolkit): ابزارهای پایهای برای تمیزکاری، توکنسازی، ریشهیابی و تحلیل ساده متن فراهم میکند و برای شروع کار با NLP بسیار مناسب است.
- spaCy: سرعت بالاتری دارد و برای کاربردهای صنعتی و مقیاسپذیر طراحی شده است. قابلیتهایی مانند تشخیص موجودیتهای نامگذاری شده (NER) و تحلیل وابستگی (Dependency Parsing) را ارائه میدهد.
- Hugging Face Transformers: این پلتفرم، مجموعهای گسترده از مدلهای از پیش آموزشدیده مانند BERT، GPT و T5 را ارائه میدهد. با استفاده از این کتابخانه، توسعهدهندگان میتوانند به سرعت مدلهای قدرتمند را برای کارهای مختلف NLP به کار بگیرند و حتی آنها را روی دادههای خود تنظیم کنند.
این مجموعهها زمان توسعه را کاهش داده و کیفیت پروژههای NLP را به شدت بالا میبرند. در بسیاری از پروژهها، این کتابخانهها ستون فقرات فنی NLP هستند.
چارچوبهای یادگیری عمیق مثل TensorFlow و PyTorch
TensorFlow و PyTorch دو چارچوب اصلی یادگیری عمیق هستند که ساخت و آموزش شبکههای عصبی پیچیده را ساده میکنند. هر دو ابزار برای پژوهش و تولید مناسب هستند و امکان طراحی و اجرای مدلهای زبانی پیشرفته را فراهم میآورند. انتخاب بین این دو به سلیقه تیم، اکوسیستم موجود و نیازهای خاص پروژه بستگی دارد. پردازش زبان طبیعی با قدرت این چارچوبها، به سطوح جدیدی از عملکرد دست یافته است. شما میتوانید با استفاده از API هوشی، این مدلها را در پروژههای خود ادغام کنید.
روندها و آینده پردازش زبان در سال ۲۰۲۵ و بعد از آن
آینده NLP به سمت هوشمندی بیشتر، کارایی بالاتر و ادغام با سایر حوزههای هوش مصنوعی پیش میرود. مدلها باید نه تنها دقیق باشند، بلکه از نظر منابع نیز بهینهسازی شوند. ترکیب دادههای مختلف (چندرسانهای) نیز به یک روند رایج تبدیل خواهد شد.
ترکیب NLP با بینایی کامپیوتر و مولتیمودالها
مدلهای چندرسانهای (Multimodal Models) که میتوانند متن، تصویر، صدا و حتی ویدئو را به طور همزمان درک کنند، در حال تبدیل شدن به یک استاندارد جدید هستند. این ترکیب در کاربردهایی مانند جستجوی تصویری، تولید زیرنویس خودکار برای ویدئوها، و درک جامعتر از محتوا بسیار مفید است. هماهنگی متن با تصویر یا سایر دادهها، نتایج روشنتر و پاسخهای کاملتری را به کاربر ارائه میدهد و خطای مدل را کاهش میدهد. این مسیر، آینده NLP را پربارتر و کاربردیتر میکند.
حرکت به سمت مدلهای کممصرف و مقیاسپذیر
با توجه به هزینههای بالای آموزش و اجرای مدلهای بزرگ، توسعه مدلهای کممصرف و مقیاسپذیر (Efficient and Scalable Models) یک اولویت اصلی است. نسخههای کوچکتر و بهینهسازی شده، سرعت اجرا را افزایش داده و نیاز به منابع محاسباتی گرانقیمت را کاهش میدهند. این مدلها میتوانند روی دستگاههای معمولیتر و حتی دستگاههای لبه (Edge Devices) نیز اجرا شوند و شرکتهای کوچکتر را قادر میسازند تا از مزایای NLP بهرهمند شوند. با این رویکرد، پردازش زبان طبیعی در دسترستر و فراگیرتر خواهد شد. توازن میان دقت و مصرف منابع، کلید پیشرفت پایدار در این حوزه است.
مسیر یادگیری و ورود به حوزه پردازش زبان طبیعی
برای ورود به حوزه جذاب پردازش زبان طبیعی، باید گامهای مشخصی را طی کنید. ابتدا با مفاهیم پایه برنامهنویسی پایتون و آمار و احتمال آشنا شوید. سپس به سراغ کتابخانههای اصلی NLP مانند NLTK و spaCy بروید. در ادامه، مفاهیم یادگیری ماشین و یادگیری عمیق را بیاموزید و با چارچوبهایی مانند TensorFlow و PyTorch کار کنید. در نهایت، با مدلهای پیشرفته Transformer و نحوه تنظیم آنها آشنا شوید. در هوشی، شما میتوانید با ساخت توکن API و استفاده از ایجنتهای کدنویسی، به صورت عملی با این مفاهیم کار کرده و پروژههای خود را توسعه دهید.
چرا هوشی؟
در هوشی، ما ابزارها و پلتفرمی قدرتمند برای توسعهدهندگان و مدیران محصول فراهم کردهایم تا بتوانند به راحتی از پتانسیل کامل هوش مصنوعی و پردازش زبان طبیعی بهرهمند شوند. با ثبتنام در هوشی، به APIهای قدرتمند، ایجنتهای کدنویسی هوشمند و یک سیستم بیلینگ شفاف دسترسی پیدا میکنید که به شما امکان میدهد پروژههای خلاقانه و نوآورانه خود را با کمترین دردسر و بیشترین کارایی به واقعیت تبدیل کنید.