
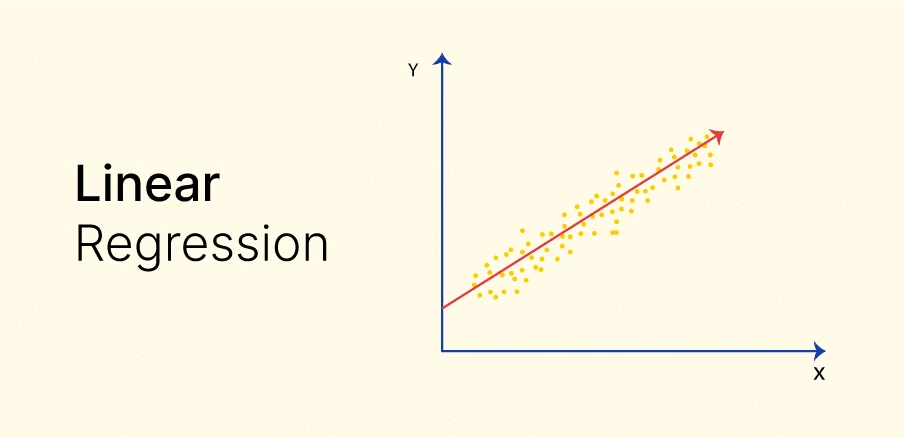
آشنایی با الگوریتمهای رگرسیون: ستون فقرات پیشبینی در هوش مصنوعی
در دنیای پرشتاب یادگیری ماشین و تحلیل داده، الگوریتمهای رگرسیون نقشی کلیدی ایفا میکنند. این الگوریتمها ابزاری قدرتمند برای درک و مدلسازی روابط میان متغیرها هستند و به ما امکان میدهند تا با تکیه بر دادههای گذشته، پیشبینیهای دقیقی برای آینده داشته باشیم. در این راهنمای جامع، به بررسی عمیق مفاهیم، انواع، ارزیابی و کاربردهای عملی الگوریتمهای رگرسیون میپردازیم و نشان میدهیم چگونه میتوانید از قدرت هوشی برای پیادهسازی و بهرهبرداری از این تکنیکها استفاده کنید.
مفهوم رگرسیون: کشف روابط پنهان در دادهها
رگرسیون به فرآیندی گفته میشود که در آن، یک متغیر وابسته (که قصد پیشبینی آن را داریم) بر اساس یک یا چند متغیر مستقل (که بر متغیر وابسته تأثیر میگذارند) مدلسازی میشود. هدف اصلی، یافتن یک رابطه ریاضی است که بتواند تغییرات متغیر وابسته را با تغییرات متغیرهای مستقل توضیح دهد. این درک عمیق از روابط، اساس بسیاری از تصمیمگیریهای مبتنی بر داده است.
انواع الگوریتمهای رگرسیون: ابزارهای متنوع برای مسائل پیچیده
الگوریتمهای رگرسیون را میتوان به دو دسته اصلی تقسیم کرد:
- رگرسیون خطی: فرض میکند که رابطه بین متغیرها خطی است. این دسته شامل رگرسیون خطی ساده (یک متغیر مستقل) و رگرسیون خطی چندگانه (بیش از یک متغیر مستقل) میشود.
- رگرسیون غیرخطی: برای مدلسازی روابط پیچیدهتر که ماهیت خطی ندارند، به کار میرود. انواع متداول آن شامل رگرسیون چندجملهای، لگاریتمی و نمایی است.
رگرسیون خطی: سادگی و قدرت در پیشبینی
رگرسیون خطی، یکی از پایهایترین و پرکاربردترین الگوریتمهاست. در رگرسیون خطی ساده، رابطه به صورت y = β₀ + β₁x + ε مدل میشود، جایی که y متغیر وابسته، x متغیر مستقل، β₀ و β₁ ضرایب رگرسیون و ε خطای مدل است. هدف، یافتن بهترین مقادیر برای ضرایب است تا خطا به حداقل برسد.
در رگرسیون خطی چندگانه، چندین متغیر مستقل (x₁, x₂, ..., xn) دخیل هستند و مدل به صورت y = β₀ + β₁x₁ + β₂x₂ + ... + βnxn + ε تعریف میشود. یافتن ضرایب بهینه در این حالت نیز برای کاهش خطای مدل ضروری است.
رگرسیون غیرخطی: انعطافپذیری برای دادههای پیچیده
زمانی که روابط در دادهها خطی نیستند، الگوریتمهای رگرسیون غیرخطی وارد عمل میشوند:
- رگرسیون چندجملهای: رابطه را به صورت چندجملهای مدلسازی میکند (مانند
y = β₀ + β₁x + β₂x² + ... + βnxⁿ + ε). - رگرسیون لگاریتمی: از تابع لگاریتم برای مدلسازی رابطه استفاده میکند (مانند
y = β₀ + β₁log(x) + ε). - رگرسیون نمایی: از تابع نمایی بهره میبرد (مانند
y = β₀e^(β₁x) + ε).
انتخاب نوع رگرسیون مناسب بستگی به ماهیت دادهها و روابط موجود بین متغیرها دارد.
ارزیابی مدلهای رگرسیون: سنجش دقت پیشبینیها
برای اطمینان از عملکرد صحیح مدلهای رگرسیون، از معیارهای ارزیابی مختلفی استفاده میشود:
- ضریب تعیین (R²): نشان میدهد چه درصدی از تغییرات متغیر وابسته توسط مدل توضیح داده میشود. مقدار نزدیک به ۱ نشاندهنده برازش بهتر مدل است.
- میانگین مربعات خطا (MSE): میانگین مربعات تفاوت بین مقادیر واقعی و پیشبینی شده را اندازهگیری میکند. مقدار کمتر، نشاندهنده دقت بیشتر مدل است.
- میانگین قدر مطلق خطا (MAE): میانگین قدر مطلق تفاوت بین مقادیر واقعی و پیشبینی شده را محاسبه میکند. این معیار نسبت به مقادیر پرت کمتر حساس است.
با استفاده از این معیارها، میتوانید بهترین مدل را برای مسئله خود انتخاب کنید. در پلتفرم هوشی، ابزارهای جامعی برای ارزیابی و مقایسه مدلهای مختلف در اختیار شما قرار میگیرد.
کاربردهای رگرسیون در دنیای واقعی
الگوریتمهای رگرسیون کاربردهای گستردهای در صنایع مختلف دارند:
- پیشبینی فروش: با تحلیل دادههای تاریخی و عوامل مؤثر مانند تبلیغات و قیمت، میتوان فروش آینده را پیشبینی کرد.
- تحلیل ریسک مالی: درک و پیشبینی بازدهی سرمایهگذاریها و مدیریت ریسک.
- پیشبینی آب و هوا: مدلسازی عوامل محیطی برای پیشبینی شرایط جوی.
- تحلیل بازاریابی: سنجش تأثیر کمپینهای تبلیغاتی و عوامل دیگر بر رفتار مشتریان.
این تنها بخشی از کاربردهای بیشمار رگرسیون است. برای پیادهسازی این مدلها در پروژههای خود، میتوانید از قابلیتهای پیشرفته هوشی بهره ببرید.
پیادهسازی الگوریتمهای رگرسیون با هوشی
پلتفرم هوشی، فرآیند پیادهسازی و استفاده از الگوریتمهای رگرسیون را برای شما آسان کرده است. شما میتوانید با استفاده از APIهای قدرتمند هوشی، مدلهای خود را بسازید، آموزش دهید و نتایج را تحلیل کنید. ایجاد یک توکن API در هوشی تنها چند کلیک زمان میبرد و شما را به دنیایی از امکانات هوش مصنوعی متصل میکند.
برای شروع، کافیست در هوشی ثبتنام کنید و اولین قدم را در ساخت ایجنتهای کدنویسی و مدلهای پیشبینیکننده بردارید. ما با ارائه مستندات کامل و پشتیبانی فنی، شما را در این مسیر همراهی خواهیم کرد.
چرا هوشی؟
هوشی با ارائه یک پلتفرم جامع و کاربرپسند، به شما امکان میدهد تا پیچیدهترین مسائل هوش مصنوعی را به سادگی حل کنید. از ساخت ایجنتهای کدنویسی سفارشی گرفته تا استفاده از مدلهای از پیش آموزشدیده و تحلیل شفاف دادهها، هوشی همراه شماست. برای کشف تمامی قابلیتها و شروع کار، به هوشی مراجعه کنید.
سوالات متداول
۱. تفاوت اصلی بین رگرسیون خطی و غیرخطی چیست؟
تفاوت اصلی در فرض آنها درباره رابطه بین متغیرهاست. رگرسیون خطی رابطه مستقیم و یکنواخت را فرض میکند، در حالی که رگرسیون غیرخطی روابط پیچیدهتر و منحنیوار را مدلسازی میکند.
۲. کدام معیار ارزیابی برای مدلهای رگرسیون بهتر است؟
انتخاب بهترین معیار به هدف شما بستگی دارد. R² میزان توضیحدهندگی کلی مدل را نشان میدهد، MSE به خطاها حساس است و MAE مقاومت بیشتری در برابر دادههای پرت دارد. معمولاً ترکیبی از این معیارها برای ارزیابی جامع استفاده میشود.
۳. چگونه میتوانم مدل رگرسیون خود را در هوشی پیادهسازی کنم؟
پس از ثبتنام در هوشی و دریافت توکن API، میتوانید با استفاده از مستندات ما و ابزارهای موجود در داشبورد، مدلهای رگرسیون خود را بسازید، دادهها را بارگذاری کنید و فرآیند آموزش و ارزیابی را انجام دهید.