
مدل ترنسفورمر: انقلابی در پردازش زبان طبیعی
مدل ترنسفورمر (Transformer Model)، که در سال ۲۰۱۷ معرفی شد، انقلابی در حوزه پردازش زبان طبیعی (NLP) ایجاد کرد. این معماری پیشرفته با بهرهگیری از مکانیزم توجه (Attention Mechanism)، قادر است روابط پیچیده بین کلمات و اجزای مختلف یک متن را به طور مستقیم درک کند. این قابلیت، ترنسفورمرها را به ابزاری قدرتمند برای طیف وسیعی از وظایف NLP، از جمله ترجمه ماشینی، خلاصهسازی متن، پاسخ به سوالات و تولید محتوا تبدیل کرده است. در این مقاله، به تشریح عمیقتر ساختار و عملکرد این مدل پرکاربرد میپردازیم.
ساختار اصلی مدل ترنسفورمر
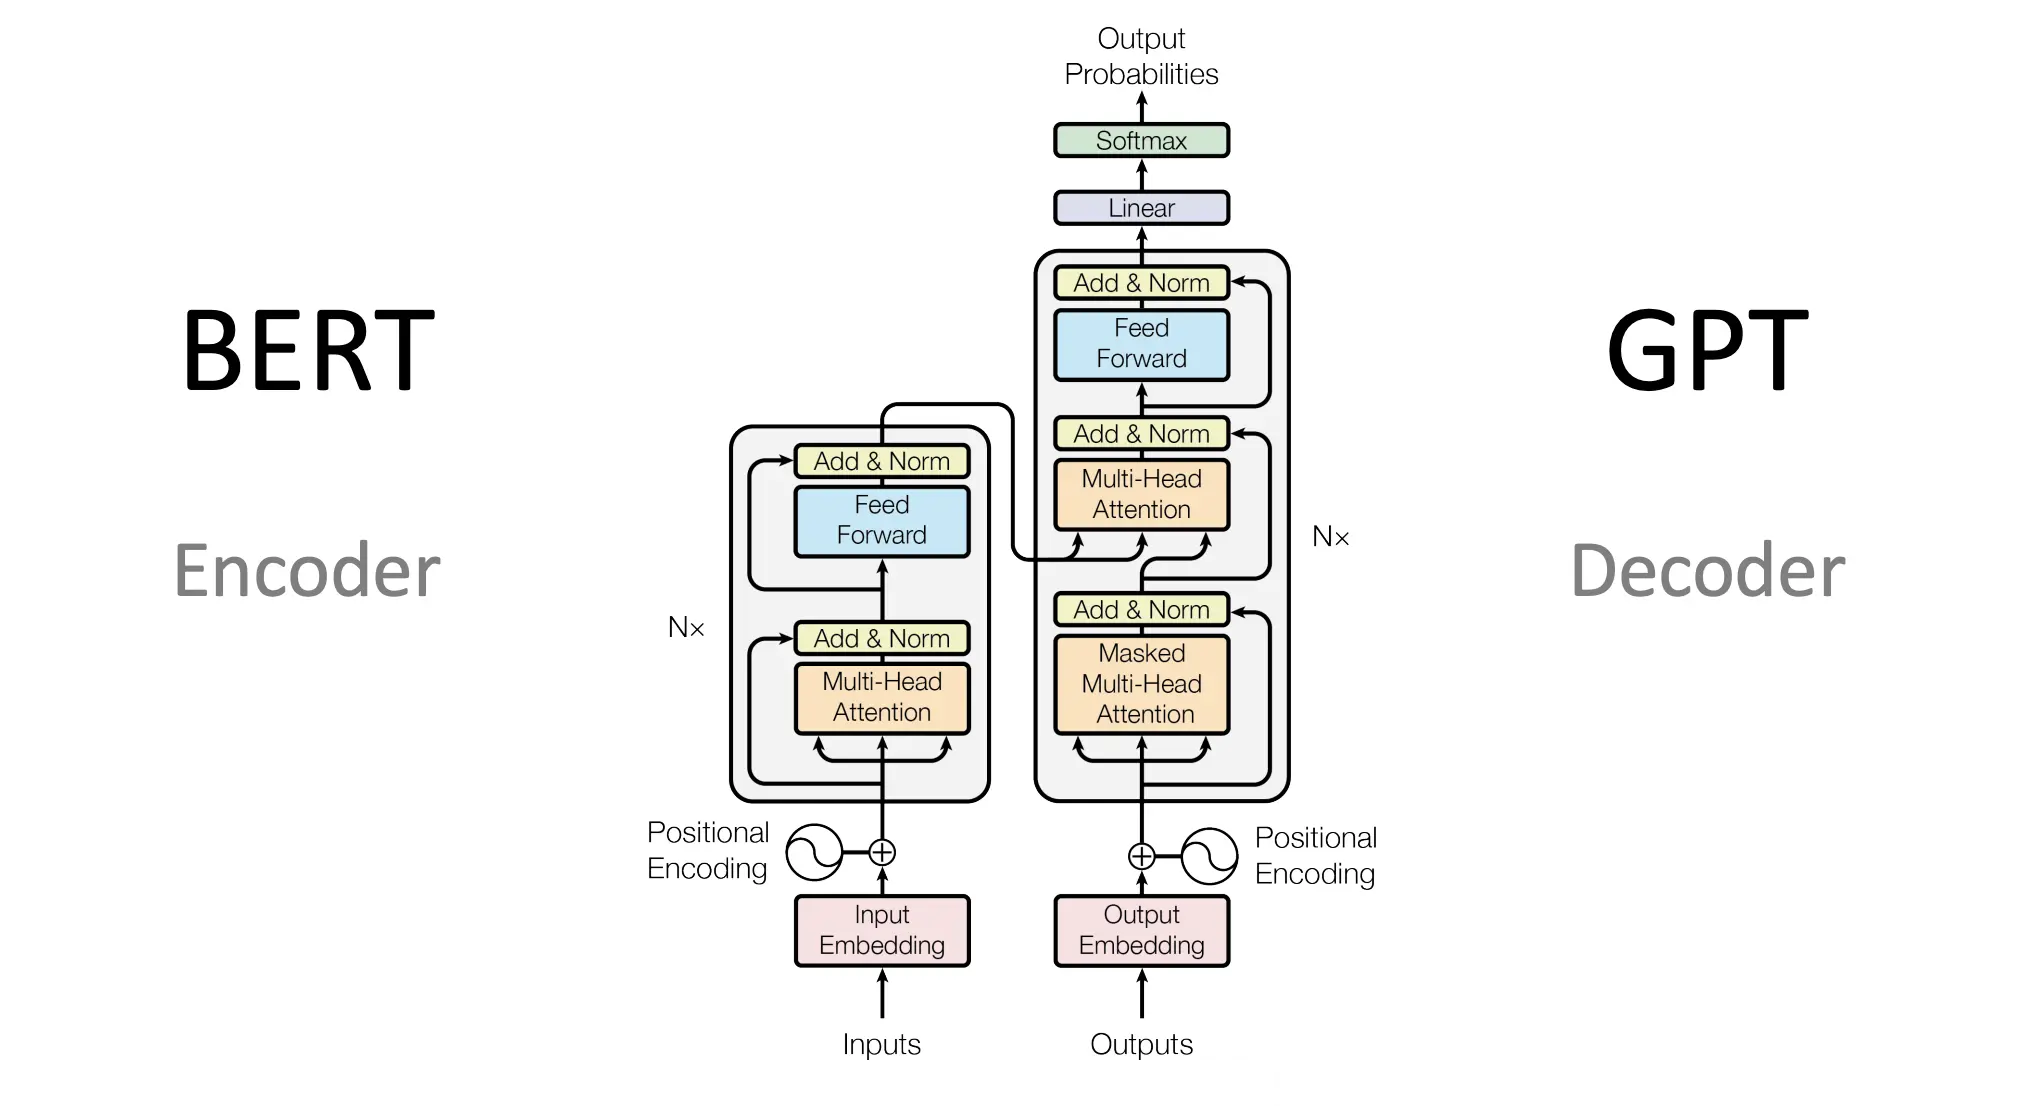
مدل ترنسفورمر از دو بخش کلیدی تشکیل شده است: رمزگذار (Encoder) و رمزگشا (Decoder). این دو بخش با همکاری یکدیگر، ورودی را پردازش کرده و خروجی مطلوب را تولید میکنند.
رمزگذار (Encoder)
وظیفه اصلی رمزگذار، تبدیل دادههای ورودی (مانند متن) به یک نمایش عددی فشرده و معنادار است. این نمایش که به آن «کد داخلی» یا «بردار زمینه» گفته میشود، حاوی اطلاعات کلیدی ورودی است و میتواند برای اهداف مختلفی مورد استفاده قرار گیرد. رمزگذار خود از چندین لایه مشابه تشکیل شده است که هر لایه شامل دو زیرلایه اصلی است:
- لایه Self-Attention: این لایه به مدل امکان میدهد تا اهمیت و ارتباط هر کلمه را با سایر کلمات در همان جمله یا متن بسنجد. این امر به درک بهتر مفهوم کلی متن کمک میکند.
- لایه شبکه عصبی پیشخور (Feedforward Neural Network): این لایه به پردازش بیشتر نمایشهای حاصل از لایه توجه میپردازد و ویژگیهای پیچیدهتری را استخراج میکند.
در ابتدای فرآیند رمزگذاری، کلمات ورودی ابتدا به بردارهای معنایی (Word Embeddings) تبدیل میشوند. سپس، برای حفظ اطلاعات مربوط به ترتیب کلمات، از «انکودینگ موقعیتی» (Positional Encoding) استفاده میشود که اطلاعات مکانی هر کلمه را به بردار آن اضافه میکند.
رمزگشا (Decoder)
رمزگشا وظیفه دارد کد داخلی تولید شده توسط رمزگذار را دریافت کرده و آن را به خروجی نهایی (مانند متن ترجمه شده یا پاسخ به سوال) تبدیل کند. رمزگشا نیز ساختاری مشابه رمزگذار دارد و از لایههای متعدد Self-Attention و شبکههای عصبی پیشخور تشکیل شده است. تفاوت اصلی در لایه توجه رمزگشا این است که علاوه بر توجه به کلمات ورودی، به کلمات تولید شده قبلی نیز توجه میکند تا از انسجام و صحت خروجی اطمینان حاصل شود.
مکانیزم توجه (Attention Mechanism)
مکانیزم توجه قلب تپنده مدل ترنسفورمر است. این مکانیزم به مدل اجازه میدهد تا در هر مرحله از پردازش، بر بخشهای مرتبطتر ورودی تمرکز کند. در لایه Self-Attention، این مکانیزم با محاسبه «امتیاز توجه» بین کلمات مختلف عمل میکند. این امتیاز نشان میدهد که هر کلمه چقدر با کلمات دیگر در ارتباط است. سپس، با استفاده از این امتیازها، یک نمایش وزنی از کلمات ایجاد میشود که اطلاعات مهمتر را برجسته میکند.
آموزش مدل ترنسفورمر
مدلهای ترنسفورمر معمولاً با استفاده از روش «یادگیری نظارتی» آموزش داده میشوند. در این روش، مجموعه دادهای شامل جفتهای ورودی و خروجی صحیح به مدل ارائه میشود. مدل با مقایسه خروجی خود با خروجی صحیح و استفاده از الگوریتم «پسانتشار خطا» (Backpropagation)، وزنهای خود را تنظیم میکند تا خطا به حداقل برسد. برای مثال، در آموزش یک مدل ترجمه، جفت جملات از زبان مبدأ و مقصد به عنوان داده آموزشی استفاده میشود.
کاربردهای مدل ترنسفورمر
مدلهای ترنسفورمر به دلیل قدرت بالا در درک و تولید زبان، در بسیاری از حوزهها کاربرد دارند:
- ترجمه ماشینی: ایجاد ترجمههای دقیق و روان بین زبانهای مختلف.
- خلاصهسازی متن: استخراج نکات کلیدی و تولید خلاصههای کوتاه از متون طولانی.
- تولید متن: نوشتن مقالات، داستانها، کدها و پاسخ به سوالات.
- تحلیل احساسات: درک و طبقهبندی احساسات بیان شده در متن.
- سیستمهای پرسش و پاسخ: یافتن پاسخهای دقیق به سوالات کاربران از متون مختلف.
چرا هوشی؟
در دنیای امروز، بهرهگیری از قدرت هوش مصنوعی برای نوآوری و توسعه محصولات امری ضروری است. پلتفرم هوشی (hooshi.net) با ارائه ابزارهای پیشرفته و دسترسی آسان به مدلهای زبانی قدرتمند، به شما کمک میکند تا قابلیتهای هوش مصنوعی را در محصولات و خدمات خود ادغام کنید. با هوشی، میتوانید به راحتی APIهای مورد نیاز خود را بسازید، ایجنتهای کدنویسی سفارشی ایجاد کنید و از شفافیت کامل در هزینهها بهرهمند شوید. همین امروز برای شروع، به هوشی مراجعه کنید و دنیای جدیدی از امکانات را کشف نمایید.
سوالات متداول
-
مدل ترنسفورمر چگونه با مدلهای قبلی مانند RNN تفاوت دارد؟
تفاوت اصلی در نحوه پردازش توالیهاست. مدلهای RNN کلمات را به صورت ترتیبی و پشت سر هم پردازش میکنند که میتواند منجر به فراموشی اطلاعات اولیه در جملات طولانی شود. اما ترنسفورمرها با استفاده از مکانیزم توجه، میتوانند به طور همزمان به تمام کلمات ورودی دسترسی داشته باشند و روابط بین آنها را بهتر درک کنند.
-
مکانیزم توجه (Attention Mechanism) دقیقاً چه کاری انجام میدهد؟
مکانیزم توجه به مدل اجازه میدهد تا در هر مرحله، وزن بیشتری به کلمات یا بخشهای مهمتر ورودی بدهد. این مانند این است که هنگام خواندن یک متن، روی کلمات کلیدی تمرکز بیشتری داشته باشید تا مفهوم اصلی را بهتر درک کنید.
-
آیا مدل ترنسفورمر فقط برای زبان انگلیسی کاربرد دارد؟
خیر، مدلهای ترنسفورمر برای پردازش انواع زبانها طراحی شدهاند و با دادههای مناسب میتوانند برای زبانهای مختلف، از جمله فارسی، آموزش داده شوند و عملکرد خوبی از خود نشان دهند.